Stimmbilder
Automatisch transferiert von altem Blog
18. Juni 2026
Es gibt KI-Modelle, die Audio nativ verarbeiten können und mehr als nur den Inhalt sehen. Diese Fähigkeit hat bei mir Begehrlichkeiten geweckt, weil ich mir erhofft habe, eine verlässliche Einschätzung zu bekommen: ob meine Stimme als eher weiblich oder männlich wahrgenommen wird.
Mittlerweile habe ich mich von dem Bild, welches meine Stimme bei anderen hervorbringen könnte, gelöst, auch wenn es mich manchmal doch noch aufreibt. Aber auch habe ich nicht mehr das Gefühl, ich könnte mich auf die Einschätzung dieser multimodalen Sprachmodelle verlassen.
Ich glaube, dass die Personabeschreibung nicht nur von der eigentlichen Stimme abhängt, sondern auch von dem Inhalt des Gesprochenen. Einem multimodalen Sprachmodell stehen ganz andere Irrwege offen als einem speziell gebauten Modell wie prithivMLmods/Common-Voice-Gender-Detection. Eigentlich müsste ich mal einen Benchmark laufen lassen auf z.B. dem Mozilla Common Voice Datensatz.
Naja egal. Ich habe drei kurze Sprachnotizen eingesprochen, einmal hab ich drauflos sinniert, was ich einsprechen könnte, dann hab ich den Anfang eines Apfelkuchenrezeptes vorgelesen, und dann eine Einleitung zu Barbecue.
Gemini-Flash-3.5 hat eine Porträtbeschreibung erstellt und GPT-Image 2 hat diese dann generiert:
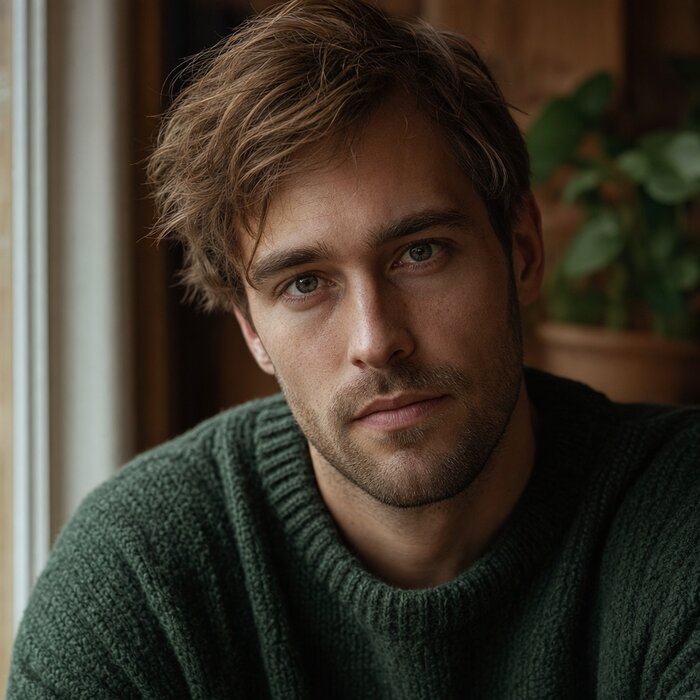
Ein detailreiches, intim wirkendes Porträt eines etwa 32-jährigen Mannes mit einem nachdenklichen, sanften und ehrlichen Gesichtsausdruck. Er hat wache, tiefgründige Augen, eine feine Nasenform und einen ganz kurzen, gepflegten Dreitagebart. Seine leicht unordentlichen, dunkelblonden Haare fallen natürlich und locker nach vorne. Er trägt einen schlichten, hochwertigen Crewneck-Strickpullover aus weicher, waldgrüner Wolle mit deutlich erkennbarer Textur. Das Bild ist geprägt von einer ruhigen, introspektiven Atmosphäre, erzeugt durch warmes, weiches Seitenlicht, das von einem nahen Fenster fällt und sanfte Schatten auf seine Gesichtszüge wirft. Er befindet sich in einem dezent gestalteten Innenraum, wobei der Hintergrund in warmen Holztönen und dem sanften Grün einer Zimmerpflanze verschwimmt. Die Kameraeinstellung ist ein nahes Porträt mit geringer Tiefenschärfe, sodass die feine Hautstruktur und der nachdenkliche Blick im absoluten Fokus liegen.
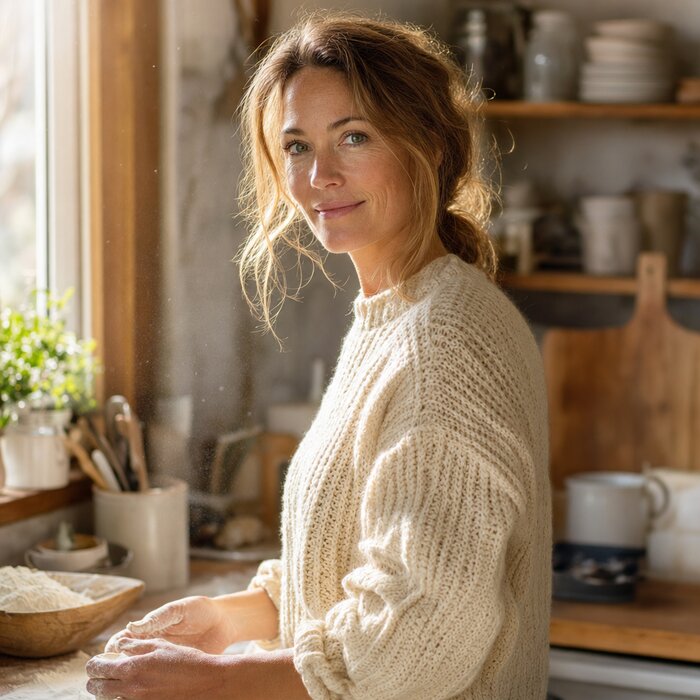
Ein Porträt einer etwa 40-jährigen Frau mit einem warmen, ruhigen Gesichtsausdruck. Ihre klare, helle Haut ist von feinen Lachfalten um die Augen und dezenten Sommersprossen auf dem Nasenrücken geprägt. Sie hat schulterlanges, naturblondes bis hellbraunes Haar, das locker im Nacken zusammengebunden ist, wobei ein paar verspielte Strähnen ihr Gesicht umrahmen. Ihr Blick aus klaren, grünen Augen ist aufmerksam und geerdet, begleitet von einem leisen, andeutungsvollen Lächeln. Sie trägt einen gemütlichen, grob gestrickten Pullover aus cremefarbener Wolle mit weicher Textur. Sie steht in einer lichtdurchfluteten, rustikal-modernen Küche; im weichgezeichneten Hintergrund sind hölzerne Arbeitsplatten und ein flüchtiger Hauch von Mehlschleier in der Luft zu erkennen. Das warme, goldene Nachmittagslicht fällt von der Seite durch ein großes Fenster auf ihre Silhouette, hebt die feine Textur ihrer Kleidung hervor und schafft eine friedliche, behagliche und konzentrierte Atmosphäre.
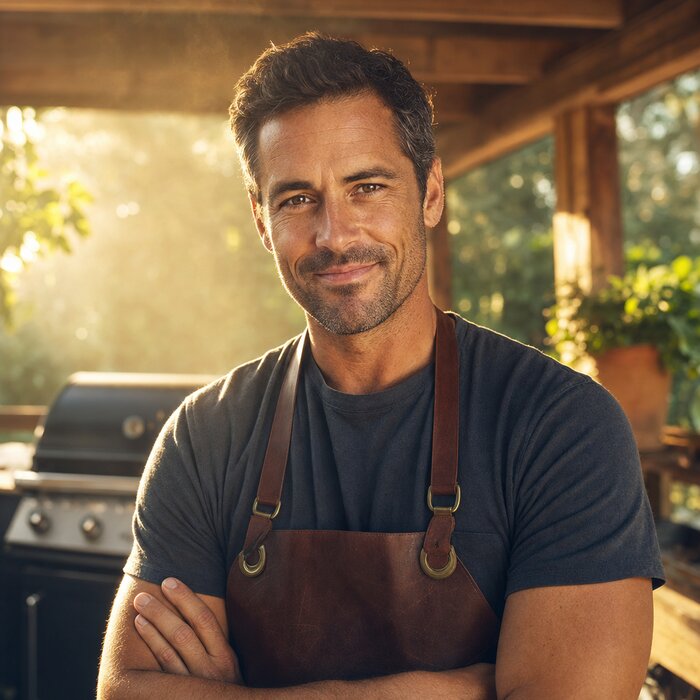
Ein Porträt eines etwa 42-jährigen Mannes mit einem herzlichen und selbstbewussten Gesichtsausdruck, der Gelassenheit und Kompetenz ausstrahlt. Er hat kurze, leicht strukturierte dunkelbraune Haare, die an den Schläfen von ersten grauen Haaren durchzogen sind, und einen sauber gestutzten Dreitagebart. Seine warmen, braunen Augen blicken direkt in die Kamera, umrandet von feinen Lachfalten. Er trägt ein gutsitzendes, dunkelgraues T-Shirt aus schwerer Baumwolle unter einer robusten, dunkelbraunen Grillschürze aus Echtleder mit Messingbeschlägen. Die Szene ist im warmen, goldenen Licht des späten Nachmittags aufgenommen, das seine Gesichtszüge weich hervorhebt und staubige Lichtstrahlen in der Luft sichtbar macht. Er befindet sich auf einer rustikalen Holzterrasse im Freien, während im stark weichgezeichneten Hintergrund die Konturen eines hochwertigen Gasgrills und ein paar grüne Gartenpflanzen im Gegenlicht verschwimmen. Die Atmosphäre ist gemütlich, einladend und authentisch, festgehalten in einem professionellen Porträtfoto mit geringer Schärfentiefe.
Obwohl diese drei Sprachnotizen alle von mir sind, hat Gemini drei unterschiedliche Personen da reininterpretiert, in keiner sehe ich mich wieder.
Alle drei sind normschön, cis-passing, weiß und erfüllen auch sonst die gesellschaftlichen Vorstellungen von der Person, die den jeweiligen Text sprechen würde.
Appendix
Skript
./generate-stimmbild.fish aufnahme.wav $OPENROUTER_API_KEY
#!/usr/bin/env fish

# Stimmbild generator
#
# Takes an audio recording of a speaker and an OpenRouter API key, then:
#   1. Asks google/gemini-3.5-flash to imagine how the speaker looks,
#      purely from their voice, and writes that description.
#   2. Feeds the description to openai/gpt-5.4-image-2 to generate an image.
#
# This script lives in the post's assets/ directory and writes its artifacts
# right beside itself, named after the input file
# (speaker-a.wav -> assets/speaker-a.{wav,txt,png}).
#
# Usage: ./generate-stimmbild.fish <audio-file> <openrouter-api-key>

set -l api_url "https://openrouter.ai/api/v1/chat/completions"
set -l description_model "google/gemini-3.5-flash"
set -l image_model "openai/gpt-5.4-image-2"

function fail
    set_color red
    echo "ERROR: $argv" >&2
    set_color normal
    exit 1
end

function step
    set_color blue
    echo "→ $argv"
    set_color normal
end

if test (count $argv) -ne 2
    fail "Usage: "(status basename)" <audio-file> <openrouter-api-key>"
end

set -l audio_path $argv[1]
set -l api_key $argv[2]

test -f "$audio_path"; or fail "Audio file not found: $audio_path"

set -l assets_dir (realpath (dirname (status filename)))

set -l base (string replace -r '\.[^.]+$' '' (basename "$audio_path"))
set -l format (string lower (string replace -r '.*\.' '' (basename "$audio_path")))

set -l audio_out "$assets_dir/$base.$format"
set -l text_out "$assets_dir/$base.txt"
set -l image_out "$assets_dir/$base.png"

# 1. Describe the speaker from their voice ------------------------------------

step "Encoding $audio_path"
set -l audio_b64 (mktemp)
base64 -w0 "$audio_path" >"$audio_b64"

set -l prompt "Du bekommst eine Stimmprobe einer Person. Die Person liest einen Text nüchtern vor. Stelle dir allein anhand der Stimme (Klangfarbe, Tonhöhe, Tempo, Akzent) vor, wie diese Person aussehen könnte. Beschreibe in konkreter Sprache ein einzelnes Porträt dieser Person (Gesicht, Ausdruck, Alter, Stil, Atmosphäre, Licht, Kleidung, Umgebung) als Vorlage für einen Bildgenerator. Antworte ausschließlich mit der Bildbeschreibung, ohne Vorrede, ohne Aufzählungszeichen, ohne Anführungszeichen."

set -l req_describe (mktemp)
set -l res_describe (mktemp)
jq -n \
    --arg model "$description_model" \
    --arg prompt "$prompt" \
    --rawfile data "$audio_b64" \
    --arg format "$format" \
    '{
        model: $model,
        messages: [{
            role: "user",
            content: [
                { type: "text", text: $prompt },
                { type: "input_audio", input_audio: { data: $data, format: $format } }
            ]
        }]
    }' >"$req_describe"

step "Describing speaker with $description_model"
curl -sS "$api_url" \
    -H "Authorization: Bearer $api_key" \
    -H "Content-Type: application/json" \
    --data-binary @"$req_describe" \
    -o "$res_describe"
or fail "Request to $description_model failed"

set -l api_error (jq -r '.error.message // empty' "$res_describe")
test -n "$api_error"; and fail "OpenRouter: $api_error"

set -l description (jq -r '.choices[0].message.content // empty' "$res_describe")
test -n "$description"; or fail "No description returned"

printf '%s\n' "$description" >"$text_out"
rm -f "$req_describe" "$res_describe" "$audio_b64"

# 2. Generate the image from the description ----------------------------------

set -l req_image (mktemp)
set -l res_image (mktemp)
jq -n \
    --arg model "$image_model" \
    --rawfile prompt "$text_out" \
    '{
        model: $model,
        messages: [{ role: "user", content: $prompt }],
        modalities: ["image"]
    }' >"$req_image"

step "Generating image with $image_model"
curl -sS "$api_url" \
    -H "Authorization: Bearer $api_key" \
    -H "Content-Type: application/json" \
    --data-binary @"$req_image" \
    -o "$res_image"
or fail "Request to $image_model failed"

set -l api_error (jq -r '.error.message // empty' "$res_image")
test -n "$api_error"; and fail "OpenRouter: $api_error"

set -l image_url (jq -r '.choices[0].message.images[0].image_url.url // empty' "$res_image")
test -n "$image_url"; or fail "No image returned"

echo "$image_url" | string replace -r '^data:[^,]+,' '' | base64 -d >"$image_out"
rm -f "$req_image" "$res_image"

# 3. Stash the original recording next to its siblings ------------------------

test "$audio_path" = "$audio_out"; or cp "$audio_path" "$audio_out"

set_color green
echo "Done"
set_color normal